EN PL DE
Vertrieb kontaktieren

Partner für KI-Infrastruktur · EU

Infrastruktur für das KI-Zeitalter.

GPU-Cloud, NVIDIA-basierte Hardware und schlüsselfertige KI-Umgebungen — geplant, beschafft und in Betrieb genommen von einem Partner, in ganz Europa.

EU-Unternehmen — Lieferung und Rechnungsstellung in der gesamten Europäischen Union
Das volle NVIDIA-Portfolio — von GeForce RTX bis Blackwell Ultra
Von der einzelnen Workstation bis zur KI-Fabrik im Rack-Maßstab
Ein Partner: Beratung, Lieferung, Inbetriebnahme, Support

Was wir tun

Drei Wege zu Rechenleistung. Ein Partner.

Mieten, kaufen oder bauen lassen. GTECH AI deckt den gesamten Weg von der ersten GPU bis zur produktiven KI-Umgebung ab.

Skalierung

Von einer GPU zur KI-Fabrik.

Jede Stufe gibt es zur Miete, zum Kauf oder als vollständig in Betrieb genommene Umgebung. Starten Sie dort, wo Sie stehen — und skalieren Sie ohne Partnerwechsel.

01

Workstation

Lokale Entwicklung, Prototyping und Inferenz für Einzelpersonen und kleine Teams.

  • GeForce RTX 5090 · RTX PRO 6000
  • NVIDIA DGX Spark · DGX Station
  • 1–4 GPUs pro Arbeitsplatz

02

Server

Produktives Training und Inferenz für eine Abteilung oder ein Produkt.

  • HGX B200 / B300 8-GPU-Systeme
  • NVIDIA DGX B300
  • RTX PRO 6000 Server Edition Nodes

03

Cluster

Multi-Node-Training mit InfiniBand- oder Spectrum-X-Fabric und parallelem Storage.

  • Dutzende bis Hunderte GPUs
  • NVIDIA Quantum-X800 InfiniBand
  • Scheduling mit Slurm oder Kubernetes

04

Rechenzentrum

Flüssigkeitsgekühlte KI-Fabriken im Rack-Maßstab für anspruchsvollste Workloads.

  • NVIDIA GB200 / GB300 NVL72
  • NVIDIA DGX SuperPOD
  • Vera Rubin NVL72 (ab 2. Halbjahr 2026)

Ausgewählte Hardware

Basierend auf NVIDIA. Verfügbar in ganz Europa.

Eine Auswahl der Plattformen, die wir liefern und in Betrieb nehmen. Spezifikationen laut NVIDIA-Dokumentation; Konfigurationen auf Anfrage.

Consumer-Flaggschiff

GeForce RTX 5090

Flaggschiff der Blackwell-Architektur für lokale KI-Entwicklung, Rendering und Inferenz.

  • Speicher32 GB GDDR7
  • CUDA-Kerne21.760
  • Leistungsaufnahme575 W
Mehr erfahren – GeForce RTX 5090

Workstation & Server

RTX PRO 6000 Blackwell

96 GB ECC-Speicher für große Modelle am Schreibtisch oder im Rack — als Workstation-, Max-Q- und Server-Edition.

  • Speicher96 GB GDDR7 ECC
  • Leistungsaufnahme300–600 W
  • SchnittstellePCIe Gen 5 x16
Mehr erfahren – RTX PRO 6000 Blackwell

KI-Supercomputer für den Schreibtisch

NVIDIA DGX Spark

KI im Petaflop-Bereich auf dem Schreibtisch — Modelle mit bis zu 200 Milliarden Parametern lokal ausführen und feinabstimmen.

  • SuperchipGB10 Grace Blackwell
  • Unified Memory128 GB
  • KI-Leistung1 PFLOP FP4
Mehr erfahren – NVIDIA DGX Spark

KI-Supercomputer für den Schreibtisch

NVIDIA DGX Station

Grace Blackwell Ultra Desktop-Superchip für Modelle mit bis zu einer Billion Parametern — Rechenzentrumsklasse unter dem Schreibtisch.

  • GPU-Speicher252 GB HBM3e
  • CPU-Speicher496 GB LPDDR5X
  • KI-Leistung20 PFLOPS FP4
Mehr erfahren – NVIDIA DGX Station

8-GPU-Plattform

NVIDIA HGX B300

Acht Blackwell-Ultra-GPUs mit 2,1 TB HBM3e — der Baustein für Training und Reasoning-Inferenz im großen Maßstab.

  • GPUs8× Blackwell Ultra
  • GPU-Speicher2,1 TB HBM3e
  • FP4-Inferenzbis 144 PFLOPS
Mehr erfahren – NVIDIA HGX B300

KI-Fabrik im Rack-Maßstab

NVIDIA GB300 NVL72

72 Blackwell-Ultra-GPUs und 36 Grace-CPUs in einem flüssigkeitsgekühlten Rack, das wie eine einzige riesige GPU arbeitet.

  • GPUs / CPUs72 / 36
  • GPU-Speicher20 TB HBM3e
  • NVLink-Bandbreite130 TB/s
Mehr erfahren – NVIDIA GB300 NVL72

Spezifikationen laut NVIDIA-Produktdokumentation, Stand September 2026. Verfügbarkeit und Lieferzeiten hängen von Konfiguration und Allokation ab.

So arbeiten wir

Ein klarer Weg von der Anforderung zum laufenden Workload.

Fünf Schritte, jeder mit einem Ergebnis und einem Entscheidungspunkt — ob Sie eine GPU mieten oder ein Rechenzentrum bauen.

01

Discover

Wir erfassen Ihre Workloads, Modelle, Daten und Rahmenbedingungen — und definieren, was Erfolg bedeutet.

Ergebnis: Anforderungen & Dimensionierungsmodell

02

Design

Architektur und TCO: Cloud, On-Premises oder hybrid, mit einer Stückliste, die Sie freigeben können.

Ergebnis: Architektur & aufgeschlüsseltes Angebot

03

Source

Beschaffung über autorisierte Kanäle, transparente Preise, EU-Logistik und Zollabwicklung inklusive.

Ergebnis: konfigurierte, getestete Systeme

04

Deploy

Installation, Verkabelung, Software-Stack und Validierung — übergeben mit Dokumentation und Benchmarks.

Ergebnis: laufende, dokumentierte Umgebung

05

Support

Monitoring, Updates, Kapazitätsplanung und Erweiterung — als Service mit SLA.

Ergebnis: definierte Reaktionszeiten

Warum GTECH AI

Engineering zuerst. Handel danach.

Wir sind ein Infrastrukturunternehmen, das Hardware verkauft — kein Reseller, der gelegentlich konfiguriert.

Dimensionierung nach Workload

GPUs, Speicher, Netzwerk und Storage dimensionieren wir anhand Ihrer tatsächlichen Modelle und Durchsatzziele — nicht anhand einer Preisliste.

In der EU, nach EU-Recht

Polnisches Unternehmen, EU-USt-IdNr., Rechnungsstellung und Lieferung in der gesamten Union. Cloud-Services in EU-Rechenzentren mit DSGVO-konformer Verarbeitung.

Kompletter Stack, als Ganzes validiert

NVIDIA-GPUs, NVIDIA-zertifizierte Systeme, NVIDIA-Netzwerk und die Software, die alles verbindet — getestet vor der Übergabe.

Mieten, kaufen oder hybrid

In der Cloud starten, on-premises wechseln, sobald die Auslastung es rechtfertigt — gleicher Partner, gleiche Architektur, keine Überraschungen bei der Migration.

Transparente Preise

Aufgeschlüsselte Angebote, reale Lieferzeiten, keine versteckten Gebühren. Sie sehen genau, wofür Sie zahlen.

Support, der bleibt

Die Engineers, die Ihre Umgebung planen, sind dieselben, die sie danach betreuen.

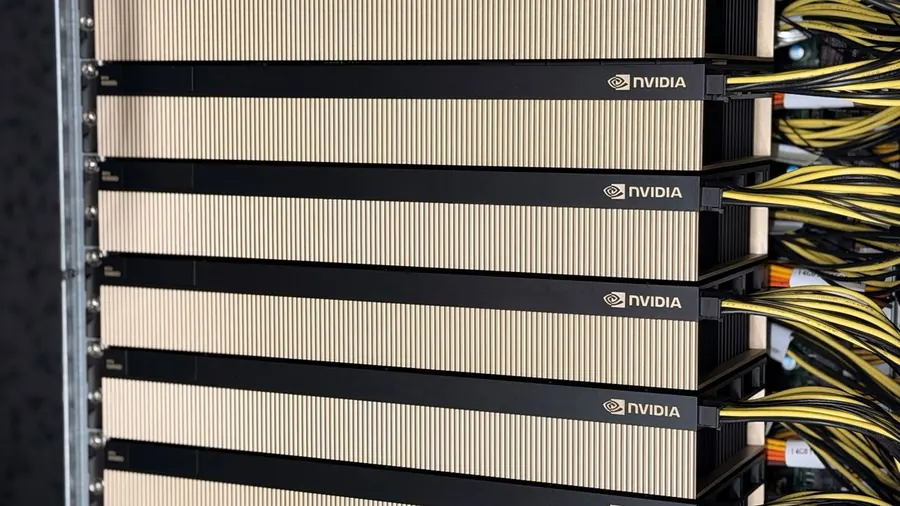
Echte Installationen

Installiert, nicht gerendert.

Einige Fotos aus Racks, die wir gebaut, bestückt und in Betrieb genommen haben — GPU-Nodes, Storage, Fabric und die Arbeit dazwischen.

Anwendungsfälle

Wo unsere Kunden KI betreiben.

LLM-Training & Fine-TuningMulti-GPU- und Multi-Node-Training mit InfiniBand-Fabric und schnellem parallelem Storage.
Inferenz & KI-AgentenLatenzarmes Serving mit TensorRT-LLM, vLLM und NVIDIA NIM Microservices; FP4 auf Blackwell.
Computer VisionQualitätsprüfung, Videoanalyse und Robotik-Pipelines am Edge und im Rechenzentrum.
Forschung & HPCSimulation, wissenschaftliches Rechnen und Hochschul-Cluster mit Slurm-Scheduling.
Medien & RenderingGenerative Videos, 3D-Rendering und virtuelle Produktion auf RTX PRO und GeForce RTX.
Industrie & FertigungPredictive Maintenance, digitale Zwillinge und On-Premises-KI, wo Daten den Standort nicht verlassen dürfen.

Sprechen wir

Sagen Sie uns, was Sie betreiben wollen. Wir sagen Ihnen, was es braucht.

Beschreiben Sie Workload, Zeitplan und Budget — Sie erhalten einen Architekturvorschlag und ein aufgeschlüsseltes Angebot, keine Verkaufspräsentation.

Wir antworten auf Deutsch, Englisch und Polnisch.