Analyse & Dimensionierung
Workload-Analyse, Profiling von Modellen und Daten, Durchsatzziele, Dimensionierung von GPU/Speicher/Netzwerk und TCO-Vergleich: Cloud vs. On-Premises vs. Hybrid.
KI-Infrastruktur
Von der Workload-Analyse bis zum validierten, dokumentierten und betreuten KI-Cluster: Wir planen und bauen On-Premises- und Hybrid-Umgebungen auf NVIDIA-Technologie — und bleiben, um sie zu betreiben.
Leistungsumfang
Workload-Analyse, Profiling von Modellen und Daten, Durchsatzziele, Dimensionierung von GPU/Speicher/Netzwerk und TCO-Vergleich: Cloud vs. On-Premises vs. Hybrid.
Designs auf Basis von NVIDIA-Referenzarchitekturen: Compute-Nodes, NVLink-Domänen, InfiniBand- oder Spectrum-X-Fabric, Storage-Ebenen, Management-Netzwerk.
Leistungsplanung im Rack, PDUs, USV-Abstimmung, Luft- oder direkte Flüssigkeitskühlung für Dichten der Blackwell-Klasse — mit Ihrem Facility-Team oder unserem.
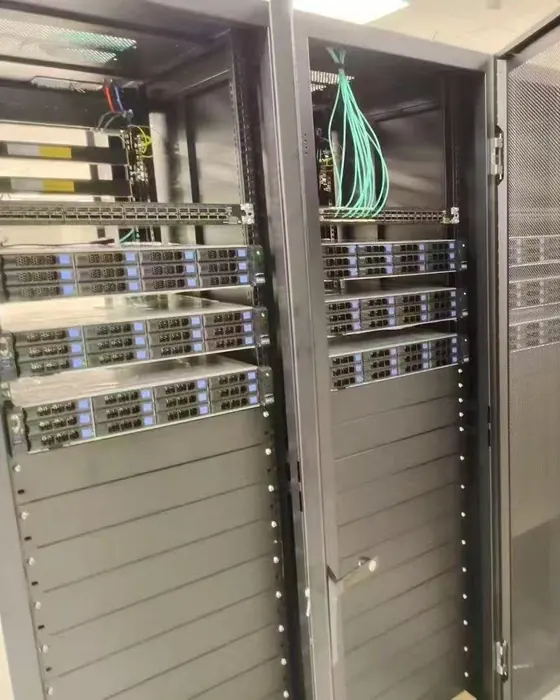
Rack-Integration, strukturierte Verkabelung, Optiken und Glasfaser für InfiniBand und Ethernet — beschriftet und dokumentiert.
Betriebssystem, Treiber, CUDA, Container-Runtime, NVIDIA AI Enterprise, Kubernetes mit GPU Operator oder Slurm — installiert, gehärtet und versioniert.
Experiment-Tracking, Pipelines, Modell-Registry und Serving (MLflow, Kubeflow, NVIDIA NIM) sowie Multi-Tenant-Scheduling für Teams.
Burn-in, NCCL- und Storage-Tests, Benchmarks mit Referenzmodellen — bei der Übergabe erhalten Sie Zahlen, keine Versprechen.
Netzwerksegmentierung, Zugriffskontrolle, Secrets-Management und Dokumentation zur Unterstützung von ISO 27001 und DSGVO-Anforderungen.
Monitoring (DCGM, Prometheus), Updates, Kapazitätsplanung, Erweiterung und SLA-basierter Support nach dem Go-live.
Ausbaustufen
Die Methode ist auf jeder Stufe dieselbe; nur die Komponenten ändern sich.
01
Einzelplatz-KI-Workstations und DGX Spark / DGX Station Rollouts für Teams, die mit lokalen Modellen starten.
02
Ein oder einige GPU-Server in Ihrem Serverraum — Inferenzplattformen und Training auf Abteilungsebene.
03
Multi-Node-Cluster mit Hochgeschwindigkeits-Fabric, parallelem Storage und Job-Scheduling für ML-Teams und Forschung.
04
Flüssigkeitsgekühlte Installationen im Rack-Maßstab und Anlagen der SuperPOD-Klasse mit vollständiger Facility-Planung.
Vorgehen
Workshops mit Ihren Data-Science-, IT- und Facility-Teams, um Workloads, Wachstumspläne, Datenflüsse und Rahmenbedingungen zu erfassen.
Detaillierte Architektur und Stückliste, validiert gegen NVIDIA-Referenzdesigns und Ihre Facility.
Beschaffung aller Komponenten über autorisierte Kanäle, mit Staging und Vormontage vor der Lieferung.
Installation vor Ort, Verkabelung, Netzwerk- und Storage-Konfiguration, Software-Deployment und Abnahmetests.
Laufender Betrieb: Monitoring, Updates, Incident Response und Kapazitätsplanung als Service mit SLA.
Ergebnisse
Aus unseren Installationen
Branchen
FAQ
Wir modellieren beides. Als Faustregel spricht eine dauerhaft hohe Auslastung über mehrere Jahre für Eigentum; schwankender oder unsicherer Bedarf für die Cloud. Da wir beides anbieten, ist die Empfehlung in keine Richtung verzerrt.
Für HGX-B300- und NVL72-Systeme ist direkte Flüssigkeitskühlung Standard; für viele 8-GPU- und RTX-PRO-Server gibt es luftgekühlte Varianten. Wir bewerten Ihre Facility und planen entsprechend.
Ja. Wir arbeiten mit Ihrem Facility-Team oder Colocation-Anbieter zusammen und empfehlen auf Wunsch EU-Colocation-Standorte, die für KI-Racks mit hoher Dichte geeignet sind.
Nodes auf Ubuntu- oder RHEL-Basis, NVIDIA-Treiber und CUDA, Container-Runtime, Kubernetes mit NVIDIA GPU Operator oder Slurm, NVIDIA AI Enterprise wo lizenziert, sowie Monitoring- und MLOps-Werkzeuge, die wir mit Ihrem Team abstimmen.
Ja — von der Garantieabwicklung bis zum SLA-gestützten Betrieb mit Monitoring, Patching und Kapazitätsplanung. Die Engineers, die die Umgebung gebaut haben, betreuen sie auch.
Analyse
Ein kurzer Workshop und ein Dimensionierungsmodell zeigen, was Ihre Workloads wirklich brauchen — bevor Sie sich auf Hardware festlegen.