Instancje GPU na żądanie
Maszyny wirtualne z dedykowanymi GPU NVIDIA (H100, H200, B200, B300, RTX PRO 6000), rozliczane godzinowo. Start w kilka minut, skalowanie w górę na czas trenowania i w dół po jego zakończeniu.
Cloud AI
Trenuj, dostrajaj i uruchamiaj modele na najnowszych GPU NVIDIA bez kupowania serwerów. Rozliczenie godzinowe, miesięczne lub rezerwacja; jedno GPU lub klaster wielowęzłowy; Twoje dane zostają w Unii Europejskiej.
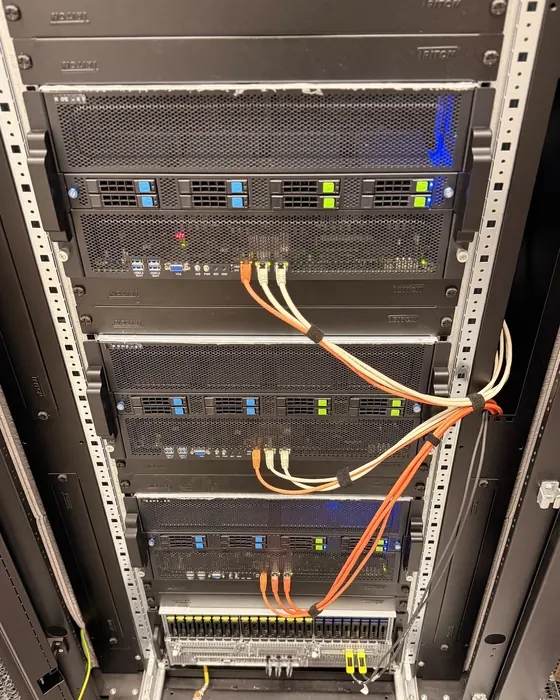
Usługi
Od godziny na pojedynczym GPU po dedykowany klaster obsługiwany dla Ciebie — wszystko na sprzęcie NVIDIA, wszystko w UE.
Maszyny wirtualne z dedykowanymi GPU NVIDIA (H100, H200, B200, B300, RTX PRO 6000), rozliczane godzinowo. Start w kilka minut, skalowanie w górę na czas trenowania i w dół po jego zakończeniu.
Serwery HGX i RTX PRO zarezerwowane wyłącznie dla Ciebie — pełna wydajność, bez „hałaśliwych sąsiadów”, dostęp root i własne obrazy.
Dedykowane środowisko GPU w centrum danych w UE, odizolowane na poziomie sieci i sprzętu, obsługiwane przez nas zgodnie z Twoimi wymaganiami compliance.
Produkcyjne endpointy modeli z autoskalowaniem, monitoringiem i kontrolą kosztów — na NVIDIA NIM, TensorRT-LLM i vLLM.
Klastry wielowęzłowe z siecią InfiniBand, równoległym storage i skonfigurowanymi frameworkami (PyTorch, NVIDIA NeMo, JAX) dla dużych treningów.
Kubernetes z obsługą GPU i NVIDIA GPU Operator, harmonogramowanie zadań, pipeline'y MLflow lub Kubeflow i observability — obsługiwane przez naszych inżynierów.
Klasy GPU
Wszystkie klasy dostępne są jako instancje, bare-metal lub zarezerwowana pojemność. Nie wiesz, którą wybrać? Zbenchmarkujemy Twoje obciążenie, zanim się zdecydujesz.
| GPU | Pamięć | Najlepsze do | Forma |
|---|---|---|---|
| NVIDIA B300 (Blackwell Ultra) | do 288 GB HBM3e | Inferencja rozumująca, trenowanie modeli o bilionach parametrów, obciążenia FP4 | Węzły 8-GPU HGX B300 |
| NVIDIA B200 (Blackwell) | 180 GB HBM3e | Trenowanie LLM i inferencja o wysokiej przepustowości | Węzły 8-GPU HGX B200 |
| NVIDIA H200 | 141 GB HBM3e | Inferencja dużych modeli, trenowanie ograniczone pamięcią | Węzły 8-GPU SXM, NVL PCIe |
| NVIDIA H100 | 80 GB HBM3 | Sprawdzony koń roboczy do trenowania i inferencji | Węzły 8-GPU SXM, PCIe |
| NVIDIA RTX PRO 6000 Blackwell Server | 96 GB GDDR7 ECC | Ekonomiczna inferencja, wizja, rendering, wirtualne stacje robocze | Serwery PCIe 1–8 GPU |
| NVIDIA L40S | 48 GB GDDR6 | Inferencja, grafika i obciążenia mieszane | Serwery PCIe |
Pojemności pamięci wg specyfikacji NVIDIA. Dostępność konkretnych klas i regionów potwierdzamy w ofercie.
Dlaczego nasza chmura
Moc obliczeniowa i storage w Unii Europejskiej, umowy według prawa UE, dostępne umowy powierzenia przetwarzania danych (RODO).
NVIDIA Quantum InfiniBand lub Spectrum-X Ethernet między węzłami — trenowanie wielowęzłowe skaluje się tak, jak obiecują benchmarki.
Lokalny NVMe w każdym węźle, równoległe systemy plików o wysokiej przepustowości dla zbiorów danych i checkpointów, storage obiektowy zgodny z S3 dla archiwów.
Ceny za GPU-godzinę lub rezerwację, jasne zasady transferu danych, faktury w EUR lub PLN z VAT UE.
Gdy przy Twoim wykorzystaniu własność staje się tańsza, projektujemy środowisko on-prem i migrujemy ten sam stos — sprzedajemy jedno i drugie, więc doradzamy uczciwie.
Wsparcie od ludzi, którzy utrzymują klastry GPU, a nie od routerów ticketów: onboarding, strojenie i reakcja na incydenty.
Zastosowania
Jak zacząć
01
Opisz nam modele, wielkość danych, frameworki i cele przepustowości.
02
Uruchamiamy Twoje obciążenie na kandydujących klasach GPU i dzielimy się liczbami.
03
Środowisko gotowe — z obrazami, storage i siecią skonfigurowanymi pod Ciebie.
04
Monitoring, wsparcie i planowanie pojemności w miarę wzrostu.
05
Rezerwacja mocy albo przejście on-prem, gdy tak wychodzi z rachunku.
FAQ
W centrach danych na terenie Unii Europejskiej. Konkretna lokalizacja zależy od klasy GPU i dostępnej pojemności; potwierdzamy ją w ofercie i w umowie powierzenia przetwarzania danych.
Tak. Na bare-metal masz dostęp root, a na instancjach pełną kontrolę nad obrazami. Udostępniamy też gotowe obrazy z CUDA, PyTorch, NVIDIA NeMo, TensorRT-LLM i vLLM.
Godzinowo dla instancji na żądanie, miesięcznie dla serwerów dedykowanych oraz stawki rabatowe dla zarezerwowanej pojemności. Wszystkie ceny w EUR lub PLN, faktury z VAT UE.
Tak — dedykowane klastry łączymy siecią NVIDIA InfiniBand lub Spectrum-X Ethernet i dostarczamy ze Slurm lub Kubernetes, gotowe do trenowania rozproszonego.
To jedna z naszych podstawowych usług. Projektujemy środowisko on-prem, dostarczamy sprzęt i przenosimy ten sam stos oprogramowania — zobacz Infrastruktura AI.
Pojemność
Podaj klasę GPU, liczbę i czas. Odpowiadamy dostępnością i ceną — zwykle w ciągu jednego dnia roboczego.