GeForce RTX 50
Konsumenckie GPU Blackwell dla deweloperów, twórców i małych wdrożeń inferencji.
GeForce RTXSprzęt AI
Od najmocniejszych konsumenckich kart graficznych po systemy Blackwell Ultra w skali szafy: pozyskujemy, konfigurujemy, dostarczamy i uruchamiamy sprzęt AI oparty na NVIDIA dla firm w całej Europie.
Portfolio
Sześć rodzin produktów, jeden dostawca — z konfiguracją, dostawą i uruchomieniem tam, gdzie ich potrzebujesz.
Konsumenckie GPU Blackwell dla deweloperów, twórców i małych wdrożeń inferencji.
GeForce RTXProfesjonalne GPU z pamięcią ECC do stacji roboczych i serwerów — do 96 GB.
RTX PROAkceleratory Hopper i Blackwell: H100, H200, B200 i B300.
Hopper i BlackwellGotowe superkomputery AI — od DGX Spark po DGX B300 i SuperPOD.
DGXPłyty 8-GPU i fabryki AI w skali szafy GB200/GB300 NVL72.
HGX i NVL72NVIDIA InfiniBand i Spectrum-X, storage AI, serwery NVIDIA-Certified i komponenty.
Sieć i daneKonsumenckie i prosumenckie
Konsumenckie GPU architektury Blackwell dla deweloperów, twórców i małych wdrożeń inferencji — najszybsza droga do CUDA na biurku. Dostępne pojedynczo, hurtowo lub wbudowane w gotowe stacje robocze.
Flagowiec
Najmocniejsze konsumenckie GPU: lokalne LLM, modele dyfuzyjne, rendering i symulacje.
Klasa wyższa
Wydajny development i inferencja przy niższym budżecie mocy.
Na zamówienie
Stacje robocze na zamówienie z 1–4 GPU, wielordzeniowymi CPU, pamięcią ECC i storage NVMe — dostarczane ze sterownikami i CUDA gotowymi do pracy.
Pełna gama GeForce RTX 50 (RTX 5070 – RTX 5090) dostępna na zapytanie, także w zamówieniach hurtowych dla laboratoriów i studiów.
Profesjonalne
Profesjonalne GPU Blackwell z pamięcią ECC, certyfikowanymi sterownikami i obsługą wielu GPU — do stacji roboczych i serwerów pod AI, symulacje, rendering i wirtualne stacje robocze.
Workstation Edition
GPU do stacji roboczych z największą pamięcią: lokalne uruchamianie modeli 100B+, fine-tuning, rendering i symulacje.
Max-Q Workstation Edition
Te same 96 GB przy 300 W — do gęsto upakowanych stacji wielo-GPU i cichszych środowisk.
Server Edition
Chłodzenie pasywne do serwerów 1–8 GPU: inferencja, wideo, VDI i mieszane obciążenia AI w firmie.
| Model | Pamięć | Maks. moc | Konstrukcja |
|---|---|---|---|
| RTX PRO 6000 Blackwell Workstation Edition | 96 GB GDDR7 ECC | 600 W | Dwuslotowa, aktywna |
| RTX PRO 6000 Blackwell Max-Q | 96 GB GDDR7 ECC | 300 W | Dwuslotowa, aktywna |
| RTX PRO 6000 Blackwell Server Edition | 96 GB GDDR7 ECC | 400–600 W | Dwuslotowa, pasywna |
| RTX PRO 5000 Blackwell | 48 GB GDDR7 ECC | 300 W | Dwuslotowa, aktywna |
| RTX PRO 4500 Blackwell | 32 GB GDDR7 ECC | 200 W | Dwuslotowa, aktywna |
| RTX PRO 4000 Blackwell | 24 GB GDDR7 ECC | 140 W | Jednoslotowa, aktywna |
Pobór mocy wg maksymalnej mocy karty podawanej przez NVIDIA. Wszystkie modele: PCIe Gen 5 x16, 4× DisplayPort 2.1 (Server Edition: opcja bez wyjść wideo).
Sprawdzone w praktyce
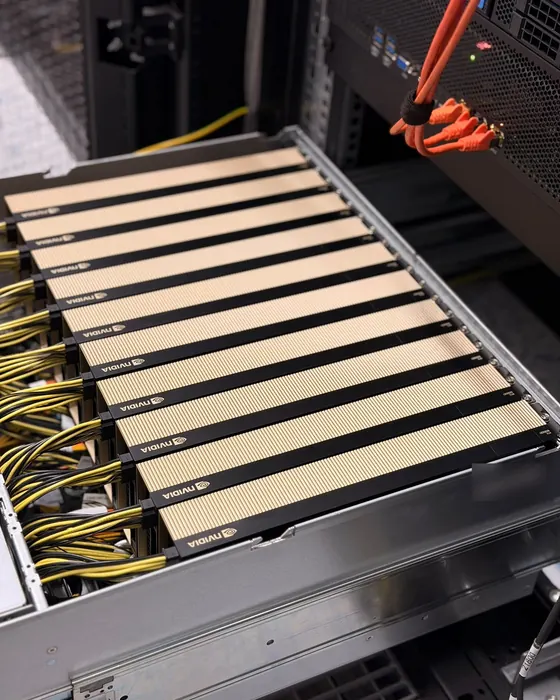
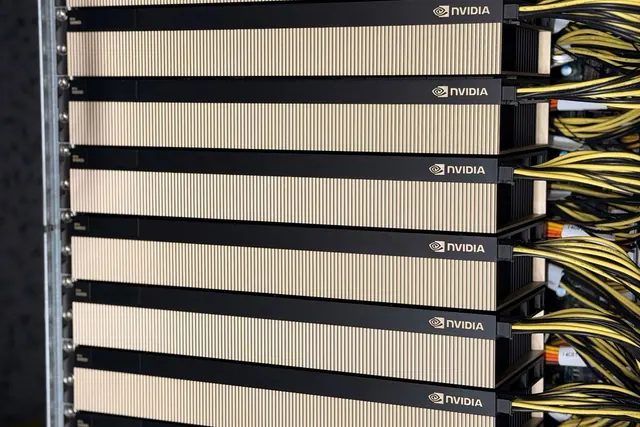
Na zdjęciu produkcyjny węzeł z jednego z naszych wdrożeń: dziesięć kart NVIDIA z serii RTX PRO 6000 Server Edition — 960 GB pamięci GDDR7 ECC — w jednej obudowie 4U chłodzonej powietrzem, z PCIe Gen 5.
Gęste węzły RTX PRO to złoty środek dla inferencji, wizji komputerowej i farm renderujących: dużo pamięci za rozsądne pieniądze, standardowe chłodzenie powietrzem i obudowy OEM dostępne od ręki.
GPU do centrów danych
Akceleratory napędzające dzisiejsze fabryki AI — dostarczane jako moduły, w płytach HGX lub jako kompletne serwery NVIDIA-Certified.
Hopper
GPU Hopper z największą pamięcią — idealne do inferencji dużych modeli i trenowania ograniczonego pamięcią.
Blackwell
Transformer Engine drugiej generacji z FP4 i NVLink piątej generacji — koń roboczy Blackwell do trenowania i inferencji.
Blackwell Ultra
1,5× więcej gęstej mocy FP4 niż Blackwell i więcej HBM3e na GPU — stworzony do rozumowania AI w dużej skali.
| GPU | Architektura | Pamięć | Przepustowość pamięci | Interconnect |
|---|---|---|---|---|
| NVIDIA H100 SXM | Hopper | 80 GB HBM3 | 3,35 TB/s | NVLink 900 GB/s |
| NVIDIA H200 SXM | Hopper | 141 GB HBM3e | 4,8 TB/s | NVLink 900 GB/s |
| NVIDIA B200 | Blackwell | 180 GB HBM3e | do 8 TB/s | NVLink 1,8 TB/s |
| NVIDIA B300 | Blackwell Ultra | do 288 GB HBM3e | do 8 TB/s | NVLink 1,8 TB/s |
Dane na GPU wg dokumentacji NVIDIA; łączna pamięć 8-GPU HGX B200 / B300: 1,4 TB / 2,1 TB HBM3e.
NVIDIA DGX
Zintegrowane systemy zaprojektowane przez NVIDIA, dostarczane i uruchamiane przez nas — od jednostki biurkowej po SuperPOD.
Biurkowy
Superchip GB10 Grace Blackwell ze 128 GB pamięci zunifikowanej: twórz, dostrajaj i uruchamiaj modele do 200B parametrów na biurku.
Biurkowy
Biurkowy superchip GB300 Grace Blackwell Ultra — wydajność klasy data center dla modeli do biliona parametrów, pod biurkiem.
Do szafy
Osiem GPU Blackwell Ultra, zintegrowana sieć NVIDIA i oprogramowanie NVIDIA AI Enterprise — firmowy budulec DGX SuperPOD.
NVIDIA DGX SuperPOD (z DGX B300 lub GB300 NVL72) projektujemy i dostarczamy według architektur referencyjnych NVIDIA — zapytaj o rozmowę wstępną.
Skala szafy
Dla największych obciążeń trenowania i inferencji: płyty 8-GPU HGX w serwerach NVIDIA-Certified oraz chłodzone cieczą szafy GB200/GB300 NVL72 działające jak jedno gigantyczne GPU.
Platforma 8-GPU
Osiem GPU Blackwell z 1,4 TB HBM3e w szerokiej gamie serwerów OEM — chłodzenie powietrzem lub cieczą.
Platforma 8-GPU
Osiem GPU Blackwell Ultra z 2,1 TB HBM3e i siecią 1,6 TB/s — stworzona pod inferencję i trenowanie ery rozumowania.
Skala szafy
72 GPU Blackwell Ultra i 36 CPU Grace w jednej chłodzonej cieczą szafie — 20 TB HBM3e połączone 130 TB/s NVLink.
| System | GPU | Pamięć GPU | NVLink | Chłodzenie |
|---|---|---|---|---|
| NVIDIA HGX B200 | 8× Blackwell | 1,4 TB HBM3e | 14,4 TB/s | Powietrze lub ciecz |
| NVIDIA HGX B300 | 8× Blackwell Ultra | 2,1 TB HBM3e | 14,4 TB/s | Powietrze lub ciecz |
| NVIDIA GB200 NVL72 | 72× Blackwell + 36× Grace | 13,5 TB HBM3e | 130 TB/s | Ciecz |
| NVIDIA GB300 NVL72 | 72× Blackwell Ultra + 36× Grace | 20 TB HBM3e | 130 TB/s | Ciecz |
| NVIDIA Vera Rubin NVL72 | 72× Rubin + 36× Vera | 288 GB HBM4 na GPU | NVLink nowej generacji | Ciecz |
Vera Rubin: NVIDIA zapowiedziała sprzęt produkcyjny dla partnerów w drugiej połowie 2026 r. — porozmawiaj z nami o planowaniu roadmapy i wczesnej alokacji.
Sieć i dane
GPU jest tak szybkie, jak dane, które do niego docierają. Dostarczamy sieć, storage i serwery NVIDIA-Certified wokół akceleratorów — oraz komponenty, dzięki którym wszystko działa.
Sieć NVIDIA
Przełączniki Quantum-X800 InfiniBand i Spectrum-X Ethernet, karty ConnectX-8 SuperNIC i DPU BlueField-3 — sieć dla trenowania wielowęzłowego.
Storage AI
Systemy all-NVMe i równoległe systemy plików wymiarowane pod zbiory danych i checkpointy; storage obiektowy zgodny z S3 dla archiwów.
NVIDIA-Certified
Serwery GPU czołowych producentów, m.in. Supermicro, ASUS, GIGABYTE, Dell Technologies, HPE i Lenovo — zwalidowane pod GPU i sieć NVIDIA.
Komponenty
Procesory serwerowe, pamięć ECC i HBM, dyski NVMe, zasilacze i risery GPU — do rozbudowy, modernizacji i napraw.
Storage
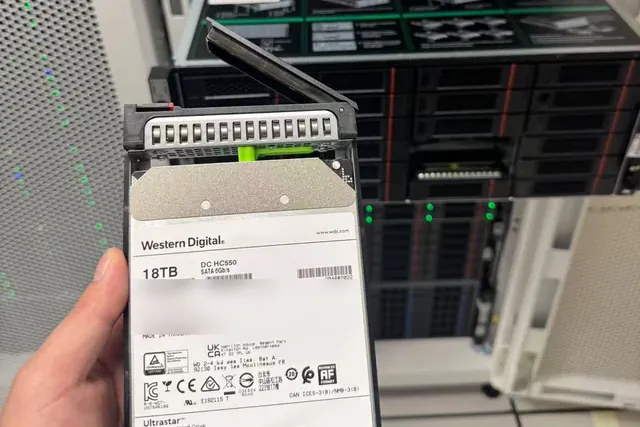
Pojemne macierze HDD na zbiory danych i archiwa, all-NVMe na checkpointy i gorące dane — zmontowane, przetestowane obciążeniowo i dostarczone razem z resztą klastra.
Zaopatrzenie i logistyka
Sprzęt z autoryzowanej dystrybucji, z pełną gwarancją producenta i numerami seryjnymi ważnymi w UE.
Ubezpieczona wysyłka do każdego kraju UE — na rampę lub do szafy — z odprawą celną dla kierunków poza Unią.
Wyceny z rozbiciem na pozycje, terminami i okresem ważności; umowy ramowe i wolumenowe dla stałych klientów.
Zakup, leasing lub wynajem — pomagamy dopasować model do przepływów pieniężnych projektu.
Systemy złożone, zaktualizowane i przetestowane obciążeniowo przed dostawą; opcjonalna instalacja u klienta.
Ścieżki modernizacji wraz z kolejnymi generacjami NVIDIA; części zamienne i obsługa RMA przez cały okres eksploatacji.
W terenie
FAQ
Tak — fakturujemy i dostarczamy w całej Unii Europejskiej (dostawa wewnątrzwspólnotowa na Twój numer VAT UE) i możemy zorganizować eksport poza UE.
Karty konsumenckie i do stacji roboczych: zwykle z magazynu lub w ciągu kilku dni. Systemy HGX i DGX: kilka tygodni, zależnie od konfiguracji i alokacji NVIDIA. Szafy NVL72: tryb projektowy. W każdej ofercie podajemy realne terminy.
Tak. Konfigurujemy, składamy, aktualizujemy firmware, instalujemy stos oprogramowania i wykonujemy testy burn-in przed wysyłką — albo uruchamiamy system na miejscu.
Tak: obsługa gwarancji, RMA, części zamienne i opcjonalne umowy wsparcia z określonymi czasami reakcji.
Dla większości klas GPU możesz najpierw zbenchmarkować obciążenie w naszej chmurze — zobacz Cloud AI.
Wycena
Prześlij model, liczbę sztuk i docelowy termin dostawy — albo tylko opis obciążenia, a my zaproponujemy konfigurację.