Analiza i wymiarowanie
Analiza obciążeń, profilowanie modeli i danych, cele przepustowości, wymiarowanie GPU/pamięci/sieci oraz porównanie TCO: chmura vs on-prem vs hybryda.
Infrastruktura AI
Od analizy obciążeń po zwalidowany, udokumentowany i wspierany klaster AI: projektujemy i budujemy środowiska on-premises i hybrydowe na technologii NVIDIA — i zostajemy, by je utrzymywać.
Zakres
Analiza obciążeń, profilowanie modeli i danych, cele przepustowości, wymiarowanie GPU/pamięci/sieci oraz porównanie TCO: chmura vs on-prem vs hybryda.
Projekty oparte na architekturach referencyjnych NVIDIA: węzły obliczeniowe, domeny NVLink, sieć InfiniBand lub Spectrum-X, warstwy storage, sieć zarządzająca.
Planowanie mocy w szafie, PDU, koordynacja UPS, chłodzenie powietrzem lub bezpośrednio cieczą dla gęstości klasy Blackwell — z Twoim zespołem obiektowym lub naszym.
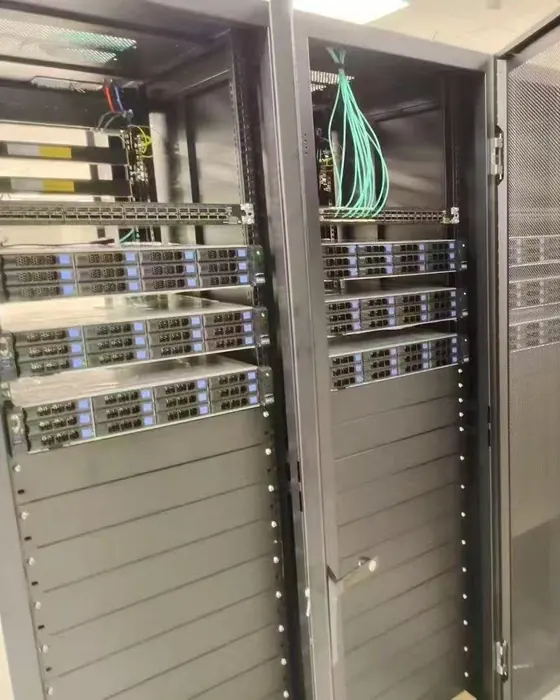
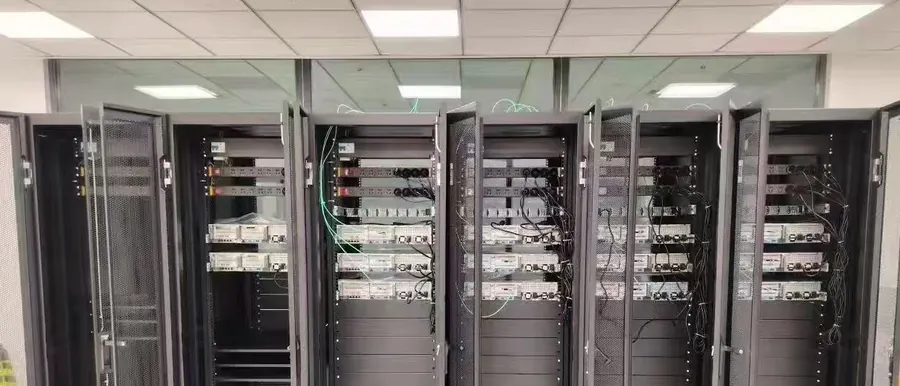
Integracja w szafach, okablowanie strukturalne, optyka i światłowody dla InfiniBand i Ethernet — oznakowane i udokumentowane.
System operacyjny, sterowniki, CUDA, środowisko kontenerów, NVIDIA AI Enterprise, Kubernetes z GPU Operator lub Slurm — zainstalowane, utwardzone i wersjonowane.
Śledzenie eksperymentów, pipeline'y, rejestr modeli i serwowanie (MLflow, Kubeflow, NVIDIA NIM) oraz harmonogramowanie multi-tenant dla zespołów.
Burn-in, testy NCCL i storage, benchmarki modeli referencyjnych — przy odbiorze dostajesz liczby, nie obietnice.
Segmentacja sieci, kontrola dostępu, zarządzanie sekretami i dokumentacja wspierająca wymagania ISO 27001 i RODO.
Monitoring (DCGM, Prometheus), aktualizacje, planowanie pojemności, rozbudowa i wsparcie SLA po uruchomieniu.
Poziomy wdrożeń
Ta sama metoda działa w każdej skali; zmieniają się tylko komponenty.
01
Jednostanowiskowe stacje AI oraz wdrożenia DGX Spark / DGX Station dla zespołów zaczynających od lokalnych modeli.
02
Jeden lub kilka serwerów GPU w Twojej serwerowni — platformy inferencyjne i trenowanie działowe.
03
Klastry wielowęzłowe z szybką siecią, równoległym storage i harmonogramowaniem zadań dla zespołów ML i badań.
04
Wdrożenia w skali szafy chłodzone cieczą i instalacje klasy SuperPOD z pełnym planowaniem obiektu.
Proces
Warsztaty z Twoimi zespołami data science, IT i obiektowym, aby uchwycić obciążenia, plany wzrostu, przepływy danych i ograniczenia.
Szczegółowa architektura i specyfikacja materiałowa, zwalidowana względem projektów referencyjnych NVIDIA i Twojego obiektu.
Zakup wszystkich komponentów przez autoryzowane kanały, ze stagingiem i wstępnym montażem przed dostawą.
Instalacja na miejscu, okablowanie, konfiguracja sieci i storage, wdrożenie oprogramowania i testy odbiorowe.
Bieżąca eksploatacja: monitoring, aktualizacje, reakcja na incydenty i planowanie pojemności jako usługa z gwarancją SLA.
Produkty projektu
Z naszych wdrożeń
Branże
FAQ
Modelujemy oba warianty. Z reguły stałe, wysokie wykorzystanie w horyzoncie kilku lat przemawia za własnością; obciążenia zmienne lub niepewne — za chmurą. Ponieważ oferujemy jedno i drugie, rekomendacja nie jest skrzywiona w żadną stronę.
Dla systemów HGX B300 i NVL72 bezpośrednie chłodzenie cieczą jest standardem; dla wielu serwerów 8-GPU i RTX PRO istnieją warianty chłodzone powietrzem. Oceniamy Twój obiekt i projektujemy odpowiednio.
Tak. Współpracujemy z Twoim zespołem obiektowym lub dostawcą kolokacji, możemy też polecić lokalizacje kolokacyjne w UE przystosowane do szaf AI o wysokiej gęstości.
Węzły na Ubuntu lub RHEL, sterowniki NVIDIA i CUDA, środowisko kontenerów, Kubernetes z NVIDIA GPU Operator lub Slurm, NVIDIA AI Enterprise tam, gdzie jest licencjonowane, a także monitoring i narzędzia MLOps uzgodnione z Twoim zespołem.
Tak — od obsługi gwarancji po eksploatację z gwarancją SLA: monitoring, aktualizacje i planowanie pojemności. Inżynierowie, którzy zbudowali środowisko, je wspierają.
Analiza
Krótki warsztat i model wymiarowania pokażą, czego naprawdę potrzebują Twoje obciążenia — zanim zobowiążesz się do zakupu sprzętu.